Un’API per l’inventario sincronizza in automatico quantità e stati di magazzino tra sistemi diversi, eliminando i disallineamenti manuali. Il valore operativo si vede subito: meno errori di stock, riordini automatici, tracciabilità completa dei movimenti. Il resto dipende dal pattern di integrazione scelto: event-driven per la reattività in tempo reale, batch per la semplicità, o soluzioni ibride quando serve entrambe le cose.
In breve:
- La sincronizzazione automatica delle quantità di magazzino grazie alle API riduce errori di stock e permette riordini più tempestivi.
- Pattern di integrazione considerando eventi in tempo reale o aggiornamenti batch influenzano la velocità e la precisione dell’aggiornamento inventariale.
- La corretta mappatura dei dati, come SKU, localizzazioni e lotti, è fondamentale per evitare discrepanze tra sistemi e stock fisico.
- È imprescindibile adottare misure di sicurezza adeguate, come l’uso di OAuth, cifratura TLS e log dettagliati, per proteggere i dati sensibili di inventario.
- Mgtitalia integra hardware modulare con il software i24Manager per registrare ogni prelievo e semplificare la tracciabilità fisica e digitale.
Indice
- Che cos’è un’API per l’inventario: modelli dati e terminologia essenziale
- Casi d’uso principali per le API di inventario
- Pattern tecnici: event-driven vs batch, overwrite vs delta
- Requisiti tecnici e modello dati operativo per integrazioni affidabili
- Autenticazione, permessi e sicurezza delle API
- Best practice operative: idempotenza, reconciliation, test e monitoraggio
- Checklist di implementazione e timeline di massima
- Come Mgtitalia applica queste integrazioni: risorse proprietarie e casi d’uso
- Prospettiva: integrazione API vs soluzione integrata hardware più software
- Come Mgtitalia può supportare un progetto di integrazione inventario
- Fonti
- Domande frequenti
Che cos’è un’API per l’inventario: modelli dati e terminologia essenziale
Un’API per l’inventario non va confusa con un’API di catalogo. Il catalogo descrive cosa vendi (nome prodotto, prezzo, categoria); l’inventario descrive quanto ne hai disponibile, dove si trova e in che stato. Sono due livelli di dati distinti, spesso gestiti da sistemi diversi che devono comunque parlarsi.
La documentazione di Square sull’Inventory API definisce tre oggetti chiave che è utile conoscere prima di progettare qualsiasi integrazione:
- InventoryCount: la quantità disponibile calcolata dal sistema, aggiornata automaticamente a ogni vendita o movimento.
- InventoryAdjustment: la registrazione di un cambiamento manuale o automatico (una rettifica, uno scarico per danneggiamento, un trasferimento tra sedi).
- InventoryPhysicalCount: il conteggio fisico effettuato da un operatore, usato per riconciliare i dati teorici con la realtà del magazzino.
Gli stati tipici includono IN_STOCK, SOLD e WASTE, ma la lista si estende facilmente a RESERVED o IN_TRANSIT a seconda del sistema. Il conteggio calcolato va bene per il giorno per giorno; il conteggio fisico resta indispensabile per correggere derive accumulate nel tempo, in genere con cadenza periodica.
Casi d’uso principali per le API di inventario
Le implementazioni più comuni seguono schemi ricorrenti, ma i requisiti tecnici cambiano parecchio da un settore all’altro.
- Sincronizzazione multicanale ecommerce: uno stock condiviso tra sito, marketplace e punto vendita fisico, aggiornato a ogni transazione per evitare overselling.
- Integrazione con provider logistici (3PL): il magazzino esterno diventa la fonte di verità per le quantità fisiche, mentre l’ERP aziendale mantiene la logica commerciale.
- Asset tracking e controllo accessi: locker e distributori automatici tracciano ogni prelievo come evento di inventario, collegando il consumo a persona, reparto o commessa.
- Hospitality e food & beverage: la rotazione rapida di prodotti deperibili richiede aggiornamenti quasi in tempo reale; secondo una guida di settore, le API in questo comparto riducono perdite e furti migliorando al contempo la reportistica.
Chi gestisce asset di valore elevato (attrezzature, strumenti condivisi) trova utile anche un riferimento contabile: lo standard IAS 16 sulle immobilizzazioni chiarisce come classificare beni che l’inventario deve tracciare nel tempo, non solo nel momento della vendita.
Pattern tecnici: event-driven vs batch, overwrite vs delta
La scelta del pattern di sincronizzazione determina quanto velocemente i sistemi restano allineati e quanto rischio di errore accetti.
- Event-driven: ogni variazione di stock genera un webhook o un messaggio su una coda, propagato immediatamente ai sistemi collegati. Richiede una gestione rigorosa dell’idempotenza, altrimenti lo stesso evento processato due volte genera doppie decurtazioni.
- Batch periodico: un job schedulato invia snapshot delle quantità a intervalli regolari. È più semplice da implementare, ma introduce una finestra di disallineamento tra un ciclo e l’altro.
- Overwrite (setTotalStock): sovrascrive l’intera giacenza con il valore inviato. Comodo per sincronizzazioni complete, ma pericoloso: la documentazione di Xentral segnala che un payload incompleto può azzerare prodotti non inclusi nella richiesta.
- Delta update: invia solo la variazione (+5, ‑2) invece del totale. Riduce il rischio di sovrascritture accidentali ma richiede una gestione più attenta della concorrenza tra richieste simultanee.
Per contesti con più sedi o provider 3PL, un pattern ibrido funziona meglio: eventi in tempo reale per le vendite, batch notturni per la riconciliazione contabile completa.
Un consiglio: dimensiona i payload batch in modo ragionevole per evitare timeout, limitando il numero di prodotti per richiesta e quindi riducendo il rischio di errori con API di terze parti che gestiscono cataloghi ampi.
Requisiti tecnici e modello dati operativo per integrazioni affidabili
La qualità di un’integrazione si gioca su decisioni di mapping dati che sembrano banali ma non lo sono affatto.
- SKU vs product ID: gli SKU sono leggibili dall’uomo ma vulnerabili a errori di digitazione o duplicazioni tra fornitori; gli ID interni sono univoci ma opachi. Molte integrazioni solide mappano entrambi, usando l’ID come chiave primaria e lo SKU come riferimento visibile.
- Aggiornamenti a livello di location: uno stock aggregato a livello aziendale nasconde carenze locali. Ogni movimento va assegnato a una location specifica (magazzino, scaffale, distributore) per avere visibilità reale.
- Lotti, scadenze e numeri seriali: per prodotti deperibili o soggetti a tracciabilità normativa, il modello dati deve prevedere campi per batch, data di scadenza (best before) e seriali individuali, non solo la quantità aggregata.
- Chunking e timeout: payload troppo grandi falliscono silenziosamente o generano timeout intermittenti difficili da diagnosticare. Suddividere le richieste in blocchi gestibili resta la strategia più affidabile.
Standardizzare gli identificatori e definire chiaramente quale sistema è la fonte di verità riduce la maggior parte delle discrepanze osservate in produzione, come indicano le stesse guide tecniche di Xentral.
Autenticazione, permessi e sicurezza delle API
Un’integrazione di inventario tocca dati sensibili sul piano operativo: chi ha accesso in scrittura può alterare le giacenze reali, non solo leggerle.
- Assegna scope OAuth distinti per lettura e scrittura delle quantità: un’integrazione di reportistica non ha bisogno di permessi di modifica.
- Traccia ogni chiamata con un campo SourceApplication (o equivalente), così ogni variazione di stock è riconducibile all’applicazione o all’utente che l’ha generata.
- Applica il principio del privilegio minimo, cifra le comunicazioni via TLS, ruota le chiavi API con regolarità e mantieni log dettagliati delle operazioni di scrittura.
Le linee guida del NIST SP 800-171 su controllo accessi e logging offrono un riferimento solido anche fuori dal contesto governativo per cui sono state scritte: applicarle a un’integrazione API aziendale migliora sia la resilienza sia la capacità di audit in caso di incidente.
Best practice operative: idempotenza, reconciliation, test e monitoraggio
Le integrazioni che funzionano bene in produzione condividono alcune abitudini precise, non solo una buona architettura iniziale.
- Idempotenza con chiavi di deduplicazione: ogni richiesta di scrittura porta un identificatore univoco, così un retry accidentale non applica due volte la stessa modifica.
- Reconciliation programmata: confronta periodicamente conteggi calcolati e conteggi fisici, segnalando automaticamente gli scostamenti sopra una soglia definita.
- Test end-to-end in sandbox: prima del rilascio, verifica scenari di errore (rete instabile, payload malformati, conflitti di concorrenza) in un ambiente isolato dai dati reali.
- Monitoraggio continuo: tieni sotto controllo il tasso di disallineamento tra sistemi (skew rate), il numero di aggiornamenti falliti e la latenza media delle chiamate.
Un consiglio: fissa una soglia di allarme sul tasso di disallineamento, non solo sugli errori espliciti. Un’integrazione può restituire sempre “200 OK” e comunque accumulare uno scarto silenzioso tra stock teorico e stock reale, visibile solo con conteggi fisici incrociati.
Checklist di implementazione e timeline di massima
Un progetto di integrazione ben scoping segue fasi riconoscibili, con deliverable chiari per ogni passaggio.
- Scoping: mappa i sistemi coinvolti, definisci la fonte di verità per ogni tipo di dato e coinvolgi IT, supply chain e il fornitore della piattaforma target.
- Design: definisci il modello dati (SKU, location, stati), scegli il pattern di sincronizzazione e disegna la gestione degli errori.
- Prototipo: costruisci un’integrazione minima su un sottoinsieme di prodotti o una sola location, per validare assunzioni prima di scalare.
- Test: esegui verifiche end-to-end in sandbox, includendo scenari di guasto e carichi realistici.
- Rollout: distribuisci per fasi (una location, poi tutte), monitorando skew rate e latenza fin dai primi giorni.
I criteri di accettazione dovrebbero includere una soglia massima di disallineamento accettabile e un tempo di risposta massimo per gli aggiornamenti critici. La durata complessiva varia molto in base al numero di sistemi coinvolti, ma saltare la fase di prototipo è l’errore più comune tra chi vuole accelerare i tempi.
Come Mgtitalia applica queste integrazioni: risorse proprietarie e casi d’uso
Mgtitalia costruisce sistemi di distribuzione automatizzata dove il software i24Manager governa tracciabilità dei prelievi, giacenze e reportistica su tutto il parco hardware installato.
- Ogni prelievo da un distributore o da un locker viene registrato con utente, quantità, orario e destinazione di costo, senza bisogno di integrazioni esterne per il tracciamento base.
- La virtualizzazione del magazzino permette di gestire scorte anche senza automazione meccanica, utile per stabilimenti con esigenze miste.
- L’integrazione con processi produttivi collega il consumo di materiali a reparti, commesse o centri di costo specifici, un livello di dettaglio che molte integrazioni API generiche faticano a replicare senza sviluppo dedicato.
Chi gestisce DPI, utensili o consumabili industriali trova in questo approccio un modo per ridurre il lavoro di mapping dati descritto nelle sezioni precedenti, perché hardware e software nascono già allineati.
Prospettiva: integrazione API vs soluzione integrata hardware più software
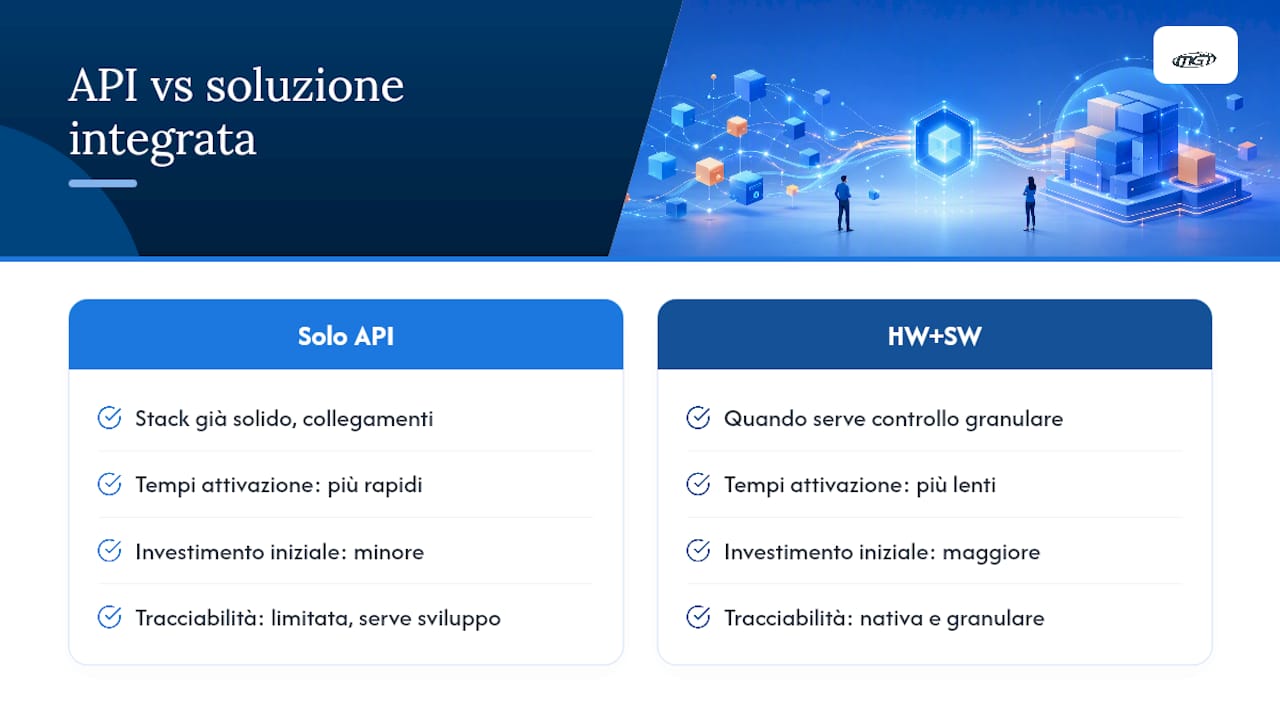
L’integrazione API pura ha senso quando lo stack esistente è già solido e serve solo collegare sistemi tra loro: tempi di attivazione più rapidi, meno investimento iniziale. Una soluzione integrata hardware più software conviene quando il controllo granulare (chi preleva cosa, quando, in che quantità) è il problema centrale, non un dettaglio accessorio.
Per organizzazioni con turni multipli e molti operatori, costruire questo livello di tracciabilità sopra un’integrazione API generica richiede spesso più sviluppo di quanto sembri all’inizio. La scala del problema, non la tecnologia in sé, decide quale strada convenga davvero.
— Amedeo
Come Mgtitalia può supportare un progetto di integrazione inventario
Chi valuta un’integrazione API per l’inventario spesso scopre a metà progetto che il vero collo di bottiglia non è il software, ma la tracciabilità fisica dei prelievi. Mgtitalia risolve questo problema alla radice: il software i24Manager si integra con hardware modulare (distributori, locker, cassettiere automatizzate) che registra ogni movimento nel momento stesso in cui accade, senza dover ricostruire eventi a posteriori da log sparsi tra sistemi diversi.

Le linee hardware, dai distributori automatici ai locker intelligenti, condividono la stessa piattaforma di controllo, così i dati di prelievo confluiscono in un’unica reportistica coerente invece che in flussi paralleli da riconciliare manualmente. Per un’azienda manifatturiera con più reparti e turni, questo significa passare dalla domanda “chi ha preso cosa?” a una risposta immediata, tracciata e collegata al centro di costo giusto. Se stai valutando come far dialogare inventario fisico e sistemi gestionali, considera una consulenza tecnica per capire quale configurazione hardware più software si adatta al tuo stabilimento.
Fonti
- NIST.SP.800-171r3
- Xentral developer docs — update stock
- APIs for Inventory Management in the Food and Beverage Industry — PolyAPI
Domande frequenti
Che cos’è un’API per l’inventario?
È un’interfaccia che permette a due o più sistemi di scambiarsi automaticamente dati su quantità, stati e movimenti di magazzino, sostituendo aggiornamenti manuali con sincronizzazione automatica.
Quali sono le fasi principali di un’integrazione API?
In genere si seguono cinque fasi: scoping dei sistemi coinvolti, design del modello dati e del pattern di sincronizzazione, prototipo su un sottoinsieme limitato, test end-to-end in sandbox e rollout progressivo per location.
Quali sono i sistemi di gestione inventario più diffusi?
Le aziende scelgono in genere tra piattaforme ecommerce con moduli di stock integrati, sistemi WMS enterprise per magazzini complessi e soluzioni integrate hardware più software come quelle di Mgtitalia, che uniscono distribuzione fisica e tracciabilità software.
Quali sono i tipi più comuni di API usate nell’inventario?
Le integrazioni di inventario si basano soprattutto su API REST per operazioni CRUD su stock e ordini, webhook per notifiche in tempo reale, e in alcuni casi API basate su code di messaggi per architetture event-driven ad alto volume.
Overwrite o delta update: quale scegliere per sincronizzare lo stock?
Il delta update è generalmente più sicuro perché invia solo la variazione, riducendo il rischio di azzerare accidentalmente prodotti non inclusi nel payload, un problema noto delle chiamate di overwrite come setTotalStock.